 星桥 API
“AI 不就会写两段挺像回事的废话吗?”
“啊?我都拿它改项目了。”
假设这俩人坐一桌,能从烤串上桌聊到店家收摊。可他们嘴里的“用 AI”,很可能压根不是同一件事。
一个在聊天框里随口问两句,一个让工具读取项目、修改文件,再拿测试结果回来继续改。拿这两种体验直接比,有点像拿“问厨师今晚吃啥”和“让后厨做一桌菜”比:都叫找厨师,交付的活儿差老远了。
Karpathy 说的差距,不只是“谁更会提问”
AI 研究者、教育者 Andrej Karpathy 在 10 月的一则 X 长帖中,谈到人们对大模型能力的理解差距。他认为,这种差距正在扩大。[1]
他给出的解释里,有三个值得拆开的因素:你交给它的任务有多大、属于什么领域,以及你能访问什么系统。这是他的观察和判断,不是“所有人用了 AI 都会提效”的调查结论。
原帖里还有他自己标为粗估的人群数字,以及对内部系统能力的描述。这些不是本文独立核实过的证据,咱们不拿来制造“再不用就落后”的焦虑。
真正能拿回来用的提醒是:评价 AI 之前,先看你让它干了什么,以及它手里有什么。
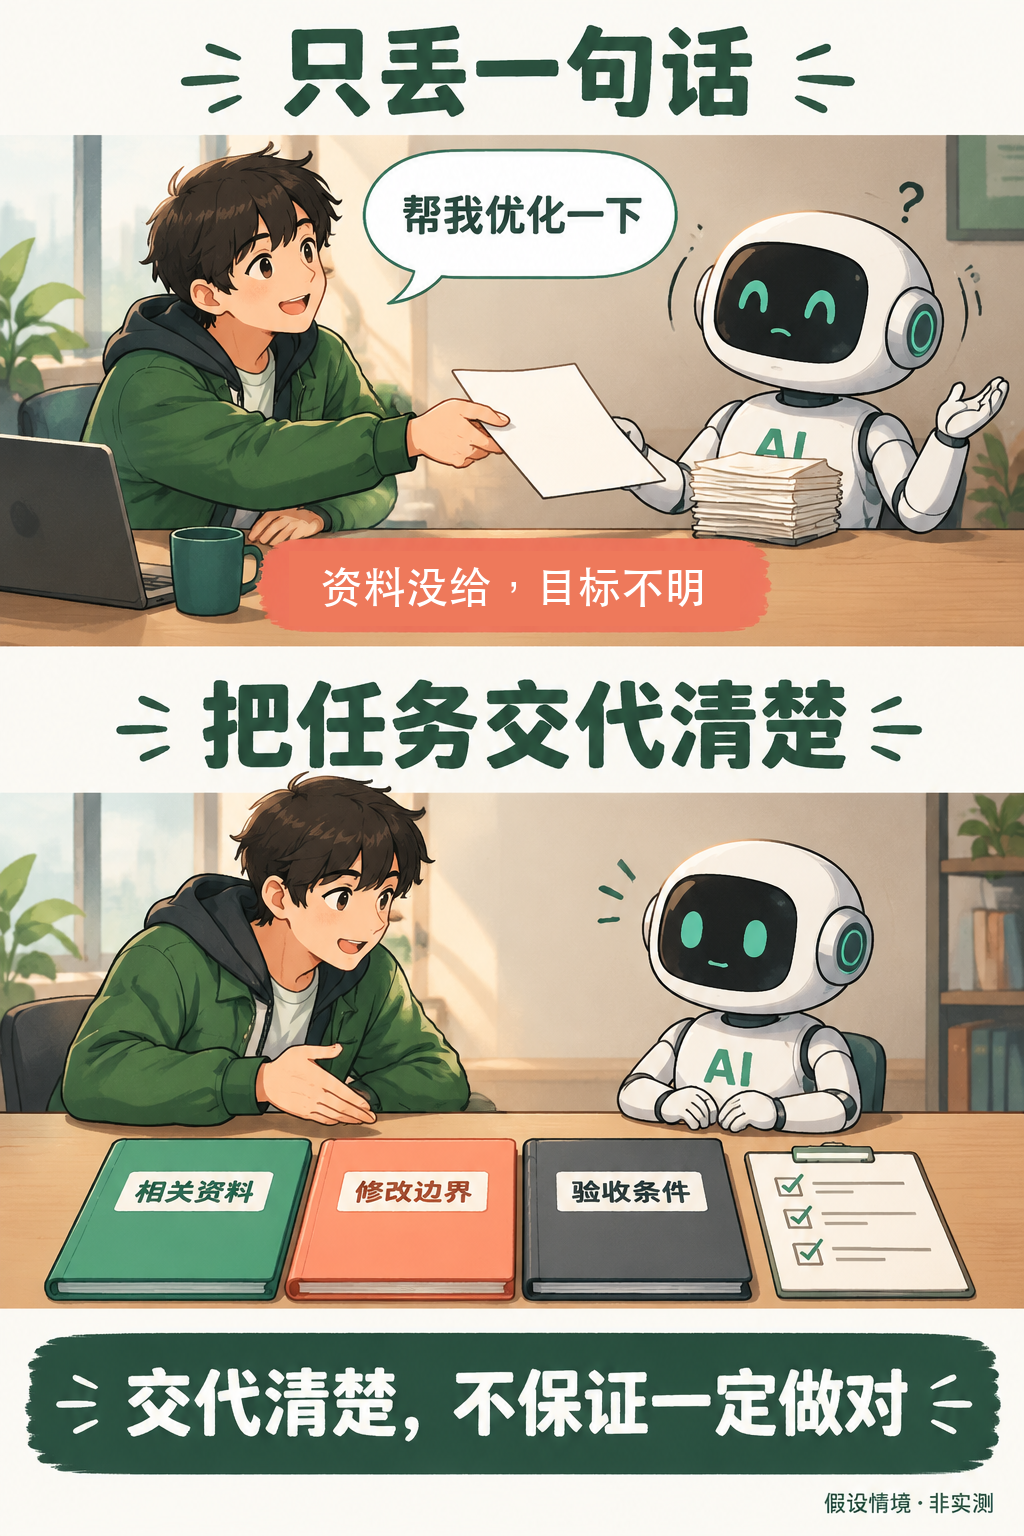
情境漫画由星桥 API 生成,局部文字经校正;人物与对话均为示意,不是采访或真实产品截图。
让它“帮我改一下”,它到底该改啥?
看一个假设的 Java 项目需求。
第一种交代是:“帮我优化订单接口。”
优化速度?调整字段?修分页?还是加个筛选?资料没给,现状没说,满意的标准也没有。模型即使认真回答,也可能只是替你脑补了一套需求。
把同一个想法收窄,任务可以变成这样:
给订单列表接口增加“按状态筛选”。现有接口说明和相关代码已附上。保留原有分页行为,不改鉴权。按本例约定,非法状态值返回 400。先找出需要改动的位置;缺资料先问,别猜。完成后补充筛选、非法值和原分页行为的测试,并列出实际运行的结果与未验证项。
这里的 400 是本例约定,不是所有项目都该照搬的规范;这段也不是已经在真实仓库里运行成功的案例。
它的价值在于把“看着差不多”换成了具体的交付条件:改什么、不改什么、拿什么判断结果。篇幅长一点不算本事,把该交代的交代清楚才算。
但还有个前提:你选的工具真能读到那些文件,且在你的授权范围内可以修改、执行测试。纯聊天框里写一句“你去测试”,不会凭空给模型变出一台开发机。
会说“改好了”,和确实改好了,中间差一次检查
Anthropic 的《Building effective agents》区分了按预定路径组织的工作流,以及由模型动态安排步骤和工具的 Agent。文章也强调,执行过程中要拿环境反馈判断进展,例如工具结果或代码执行结果。[2]
说白了,就是别让 AI 一个人在那儿汇报“我觉得行”。它改了代码,就看变更;它说测试通过,就看实际命令和结果;它没跑成功,就把失败和缺口明明白白留下来。
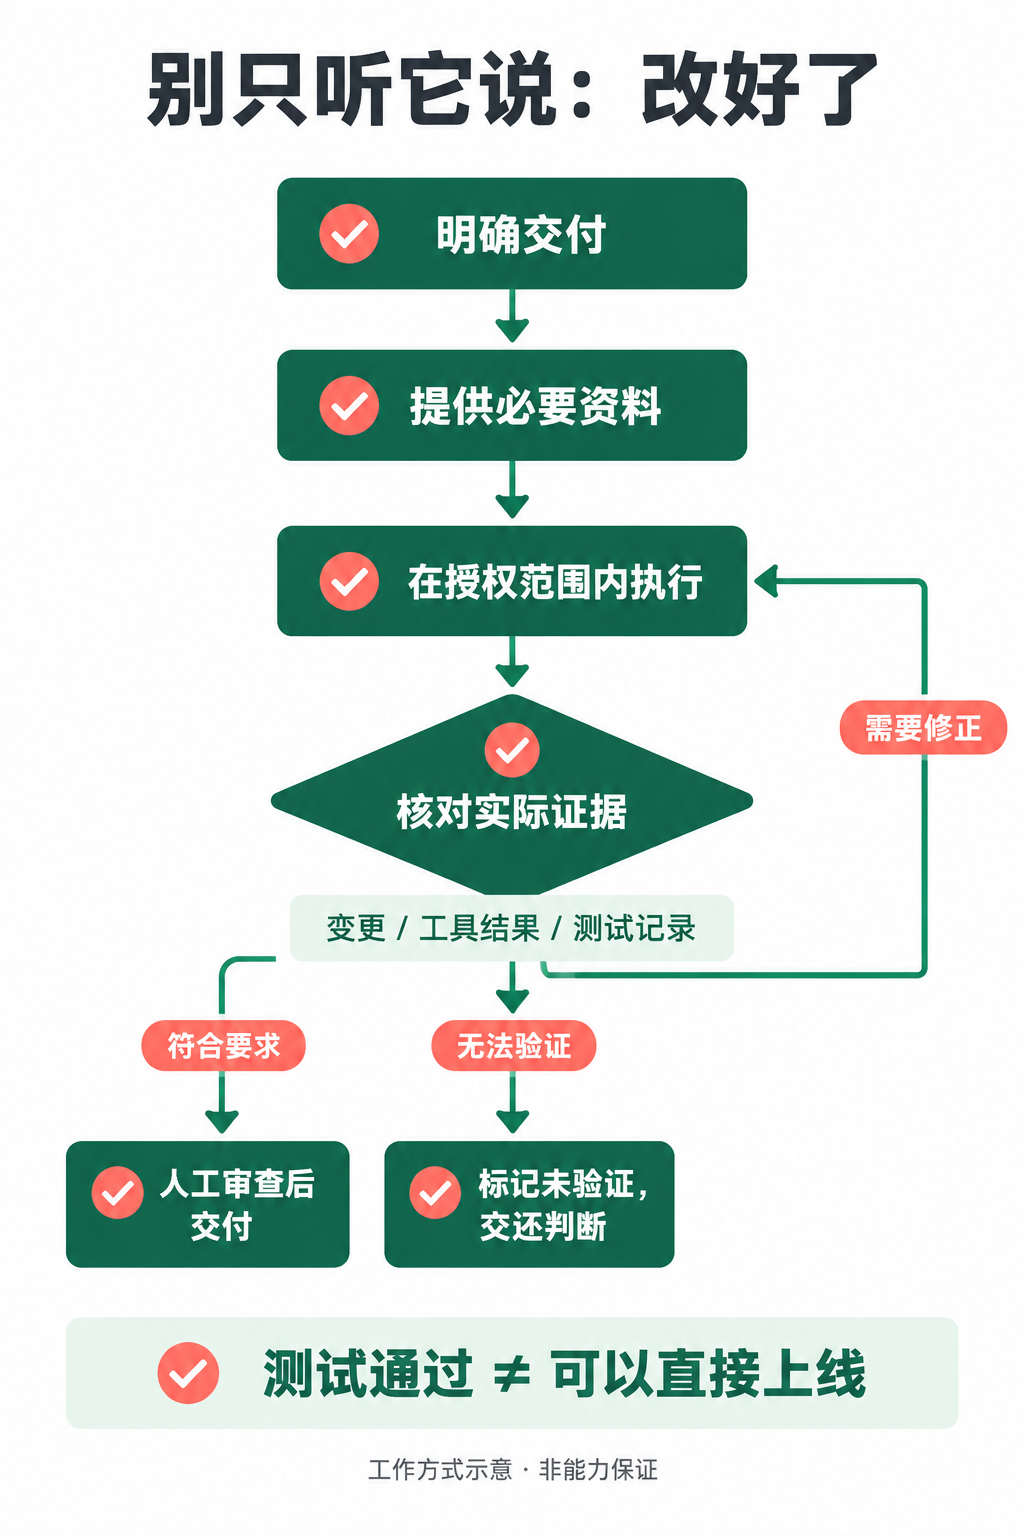
流程图由星桥 API 生成,是本文的工作方式建议,不代表任何工具已经自动具备这些能力。
测试通过也不是“随便上线”的通行证。测试可能没覆盖真实需求,代码审查仍要看系统约束、权限边界和维护成本。Anthropic 同文也提醒,Agent 会增加成本,并可能让错误在多轮操作中累积。[2]
所以,别把“没用好 AI”的责任全甩给用户。模型本身会有能力短板,工具也可能接得不对;有些活儿,人工直接干就是更省事。一个只会写得很自信、却一直交不出可核对结果的系统,不会因为多套两层 Agent 就突然靠谱。
下一次试 AI,可以挑一个你熟悉、范围小、做完能验收的真实任务。记下它完成了多少、你返工了多久、总共花了多少时间和费用。先和自己的原有做法比,别和别人剪出来的精彩演示硬碰硬。
如果你想在同一类任务上比较不同模型,星桥 API 是由我们运营的统一接入服务,可从文末“阅读原文”查看文档,具体可用模型以站内列表为准。比较时保留相同资料和验收条件,结果才有参考价值。
AI 到底有没有用,最后得看活儿。别光听它答应得挺敞亮。
本文为观点回顾与工作方式讨论,资料核验于 2026-10-30。
[1] Andrej Karpathy,X 原帖 2109361546505966046。页面时间显示 2026-10-12,未标明时区;人物身份与账号通过本人网站 karpathy.ai 交叉核验。本文仅转述相关观点,不采用原帖人群估算或未核验能力描述。
[2] Anthropic,Building effective agents,2024 年 12 月文章,现行页面已提示工具生态发生变化。本文引用工作流、环境反馈、测试与人工审查等原则,不把旧文的工具清单当成当前选型推荐。