 星桥 API
你往 AI 客户端里敲了四个字:“继续改改。”
再看用量:好家伙,输入 token 又是一大截。这四个字是镶金边了,还是模型按心情收费?
先看这次请求带了什么。保留历史的多轮聊天,计费输入可能包含之前的对话,不只有你刚敲的几个字。 本文说的是按用量计费的文本 API;订阅套餐、按次收费和多模态另有口径。
1. 你说“接着唠”,客户端得告诉它前面唠了啥
token 是模型处理文本的计量单位,不能直接按中文字数换算。
在一种常见实现里,客户端每轮会把系统提示、保留的历史消息和新问题一起交给模型。你上轮收到的长回答,也会成为下一轮的输入。
像去办事窗口问:“刚才那个,接着办。”窗口里的工作人员要知道“刚才那个”是啥,总得拿到前面的材料。
你觉得是补一句,模型收到的可能是一摞。
拿一笔假设账算算:固定提示 500 token,每轮新问题 100 token,每轮回答 200 token;每次完整保留历史,不用工具、不命中缓存,也忽略协议等额外开销。
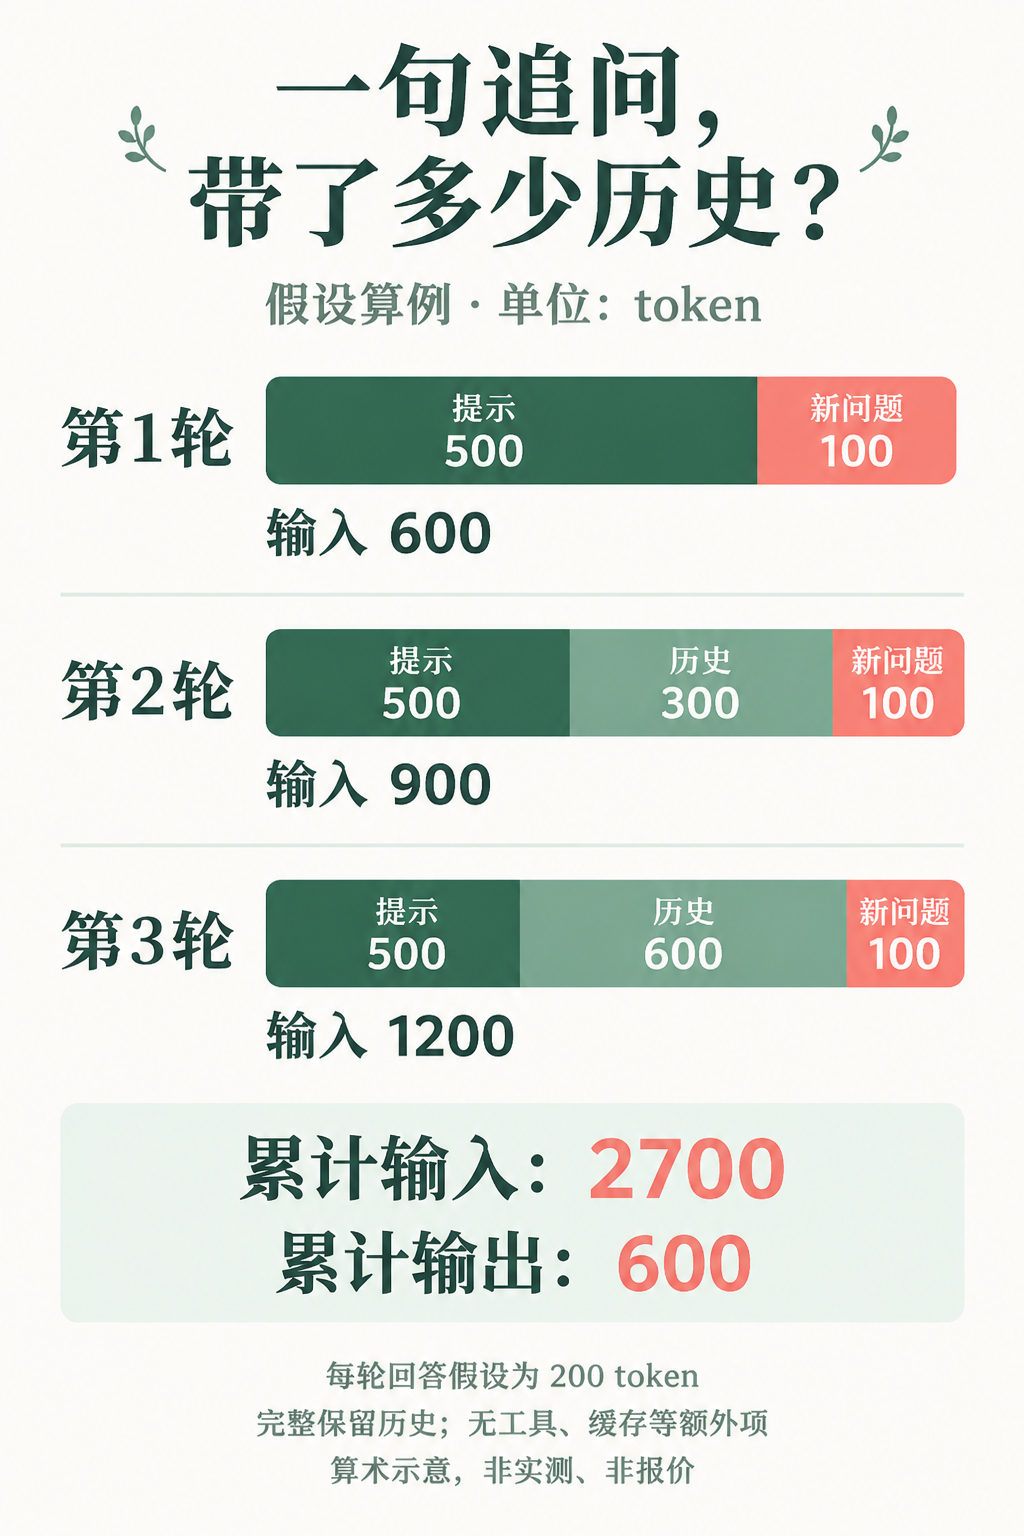
图中色块仅示意组成,不按数量比例绘制;数字是人为设定的算术示例,不是分词实测,也不是任何模型的报价。三轮下来,用户新问题合计 300 token,但三次请求累计输入是 2700 token,输出另算 600 token。
这里没有“同一段话重复输出”:是保留的旧内容,在后续请求中又作为输入参与处理。
当然,并非每个客户端都原样保留全部历史。自动裁剪、摘要、检索和缓存都会改变实际用量或费用。别光看聊天框长短,得看请求记录。
2. 换成会话 ID,就不用付历史的钱了?
会话 ID 可以省掉自己管理、反复传送完整历史的麻烦,不能据此认定历史上下文免费。
OpenAI《Conversation state》明确说明:使用 previous_response_id 时,链中之前的输入 token 仍按输入计费。[1] 这条说明有具体接口范围,其他平台和接口要查各自规则。
再有个容易串台的概念:上下文窗口是容量上限,不是你预先买下的一整包 token。 能装多少,和这次实际处理多少,是两回事。
3. 有缓存,账单是不是就稳了?
缓存可以让满足条件的重复输入按相应规则收费,但不能看到“历史一样”就认定命中。
以 OpenAI 的提示缓存说明为例,重复前缀、模型支持、缓存有效期和路由等都会影响复用;缓存读、缓存写的费率也可能不同。[2]
查账时尤其别把同一批 token 算两遍。不同接口的总输入字段是否已包含缓存,口径可能不同;应按服务的计费明细核对。
缓存像优惠票:先看有没有拿到,再看这趟能不能用。不能揣张想象中的票就上车。
4. 真想省钱,先查这条请求
先挑一条费用较高的记录,记下时间、模型、实际分组和请求 ID,再按下面的顺序排查。
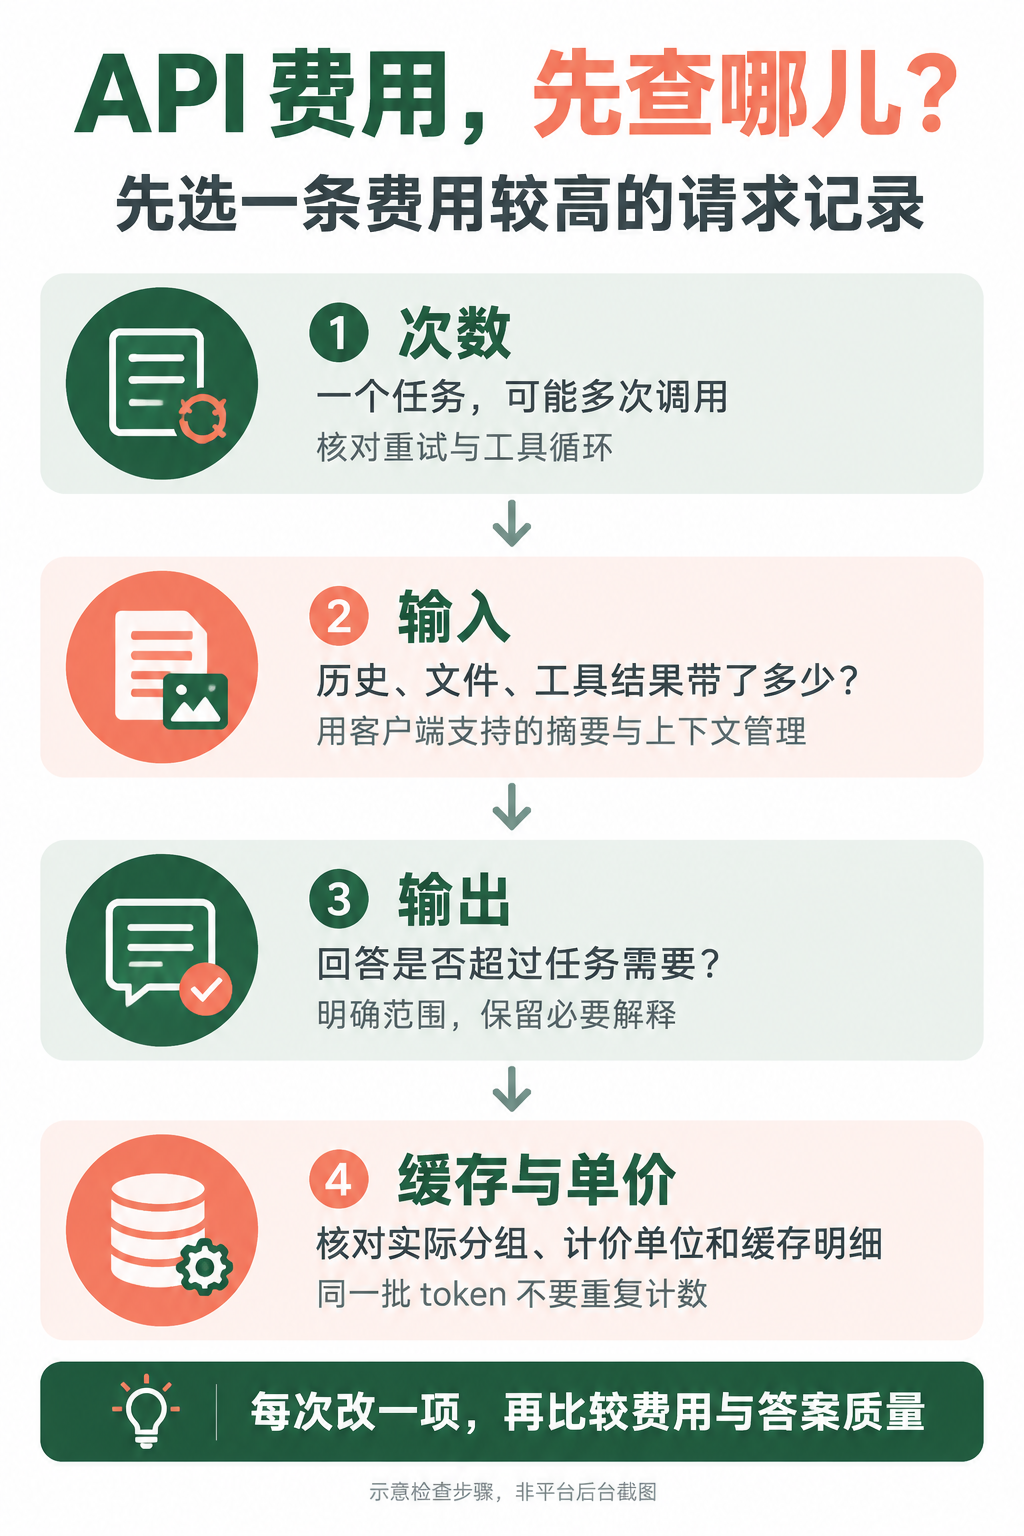
先看次数。 一个 Agent 任务可能调用模型多次。工具来回执行、程序重试,都可能产生额外请求;不要把一个任务当成一次调用。
再看输入。 是否带着早已无关的长对话、整段文件、冗长工具结果?换了任务就考虑新建对话;还要继续同一任务,则优先用客户端支持的摘要或上下文管理,保留目标、约束、关键结论和必要材料。
别手动乱砍正在执行的 Agent 消息链。部分接口需要保留工具调用和对应结果,删错了,钱没省明白,流程先断了。
再看输出。 只要一个修改点,就把要求写清楚:“只返回需要改的段落和原因。”需要完整论证时也别为了省 token 把答案截没了。
最后对缓存和价格口径。 普通输入、输出、缓存读写按实际服务规则核对。分组、单位也得一致:每千 token 和每百万 token,差着 1000 倍,别拿着两张不同的价目表硬算。[3]
每次只改一项,再用相近任务比较请求次数、用量、费用和答案是否够用。摘要后更便宜但丢了关键条件,那也不算改好了。
下次再看到“就问一句,咋花这么多”
先别急着换模型。翻开那条记录,看看它到底带了多少上下文、生成了多少内容、总共调用了几回。
你负责一句“继续”,客户端可能负责把前情提要全搬过去。账,得按实际搬的材料看。
如果你用的是由我们运营的星桥 API,可在用量记录中核对输入、输出及缓存计费明细;文末“阅读原文”进入费用说明。其他服务也可以按同样思路查各自日志。[3]
资料核对:2026-10-28。本文为机制解释,不是价格承诺或星桥实测;配图由星桥 API 调用 AI 生成,知识图按文中假设与检查步骤制作。
[1] OpenAI Docs:Conversation state,Managing context windows。
[2] OpenAI Docs:Prompt caching,缓存匹配与计费说明。
[3] 星桥 API 接入文档:费用与缓存计费、用量与日志。