 星桥 API
想让 AI 念一段稿子,打开工具一看:先上传参考音频。
咋的,让它上岗,还得先给它试个音?
不一定。把文字念出来,叫语音合成(TTS);要不要你提供录音,取决于模型怎么取得音色。 选一个已经提供的声音,和让它参考某个人的声音,是两种需求。
北京时间 2026 年 11 月 3 日,llama.cpp 的 b12061 预发布构建收录了一项 PocketTTS 更新,刚好能把这事说清楚。它增加了对 PocketTTS 无声音克隆权重中的预设音色的支持,对应 GitHub PR #31429。
这是运行工具的具体支持变化,不是 PocketTTS 今天才诞生,也不是 llama.cpp 第一次能生成语音。
你要它“会说话”,还是“说得像谁”?
假设给一段产品介绍配旁白,只要求声音清楚、风格合适,未必非得像自己。
这时,预设音色就够考虑了:模型或服务已经提供了一组声音,你从里面选。像找配音演员,翻名册挑一个,不用先把自己的录音寄过去。
声音克隆处理的是另一件事:给模型一段有权使用的参考录音,让生成声音参考录音里的说话人特征。它试图回答“像谁”,效果能像到什么程度,还得看模型和样本,不能光看功能名字。
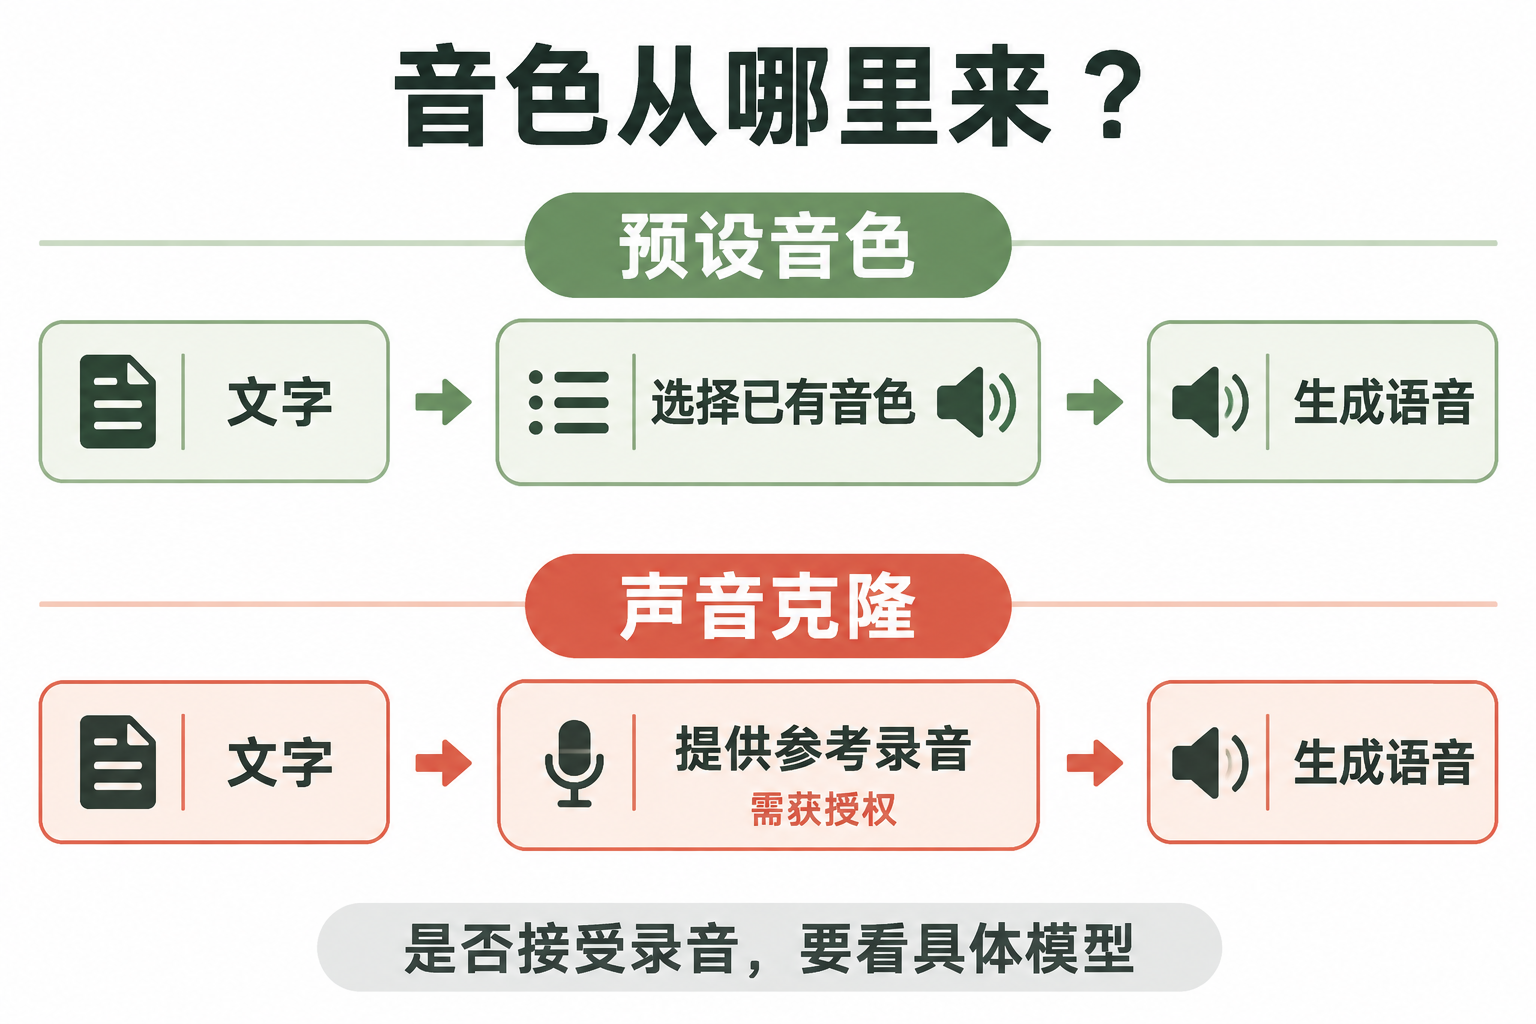
概念图:音色来自哪里。由星桥 API 生成,不是实测结果或产品界面。
两条路都能做语音合成。TTS 不等于声音克隆,没让你交录音,也不代表它没在选择音色。
预设音色也不保证“随便商用”。模型、具体声音素材和服务可能各有使用条件,真要放进广告或收费产品,得分别核对。
有的模型,你给录音,它还不收
这次更新支持的权重,名字就叫 pocket-tts-without-voice-cloning。
按这份构建的文档,模型转换时会把预设音色信息放进配套的 mmproj 文件,并省去那部分不再使用的声音编码器。可以把 mmproj 暂时理解为配套模型文件;只搬主权重、漏掉它,不是完整的运行配置。
因此,在支持这项功能的 llama.cpp 里,用这类权重时,可以指定已有音色,不指定就默认用第一个,不能再硬塞参考录音。
“不收录音”在这里是模型能力边界,不一定是上传失败。 想让它模仿自己,就得另找支持相应功能的模型和权重;多换几个音频格式,补不出它没有的编码器。
给正在看接口的朋友留几个能对照的名字,均指 llama.cpp 这份版本的接口:
GET /props:模型提供预设音色时,返回的voices列出可选名字。/tts的voice:从这些名字里选;命令行对应--tts-voice。- 这类无声音编码器的权重会拒绝参考音频。预设音色也不能和参考录音一起指定;两边都没指定时,有预设音色的模型默认选第一个。
这几个字段不是所有云端配音平台的通用规范。音色名也得查当前加载的模型,别从另一个服务抄个名字就往里填。
选声音之前,还得先确认它会念哪种语言
中文稿准备好了,看见“多语言”就开跑,容易白忙活。
截至 11 月 3 日本次核对,Kyutai 这份模型卡列出的语言是英语、法语、德语、葡萄牙语、意大利语和西班牙语,没有列中文。 llama.cpp 的 PocketTTS 文档还说明,语言取决于所用权重,不能只改个 lang 就当换了一门语言。
所以,给中文文章配音,先核对具体模型的中文支持;给已有音色换个中文名字,也教不会它普通话。
同样,能念稿不等于能实时语音聊天。识别你说的话、决定怎么回答、播放回答,以及被打断时怎么停,还是另外几件事。今天这项更新讲的是已有音色怎么选,不能拿它替整套语音助手打包票。
如果你只是缺一位旁白,先看预设音色合不合适;确实要保留某个人的声音特征,再看获授权的声音克隆。先说清自己需要哪一种,再挑模型,省得录音录了半天,最后发现人家压根不收。
资料核对:2026-11-03。本文依据发布说明和版本文档解释功能,未做部署、试听或音质与延迟测试,也不代表星桥已经上线相应语音模型。
原始资料:llama.cpp b12061(预发布)、PR #31429、该版本的 TTS 文档与服务端文档、Kyutai 模型卡。微信若不保留外部超链接,可点阅读原文进入 PR,再查对应资料。