 星桥 API
你想给聊天工具加个麦克风,寻思接口早就支持流式了,接上应该不费劲。结果屏幕上的字蹦得挺欢,AI 愣是听不见你说话。
先别跟麦克风较劲:普通文字聊天里的 stream: true,控制的是回答分批返回;它不会顺手替你录音、识别语音,更不会自动把回答念出来。 想做语音,先确定你要的是“把录音变成文字”,还是“和 AI 来回说话”。
10 月 28 日发布的 llama.cpp v0.8.0,把 /v1/realtime 实时对话、转写和 /tts 语音合成列进了更新。借这次更新,咱把几种常被叫作“流式”的能力掰扯清楚。这里讲选型与核对方法,不是已经部署跑通的教程。
先分清:你到底想让它干啥?
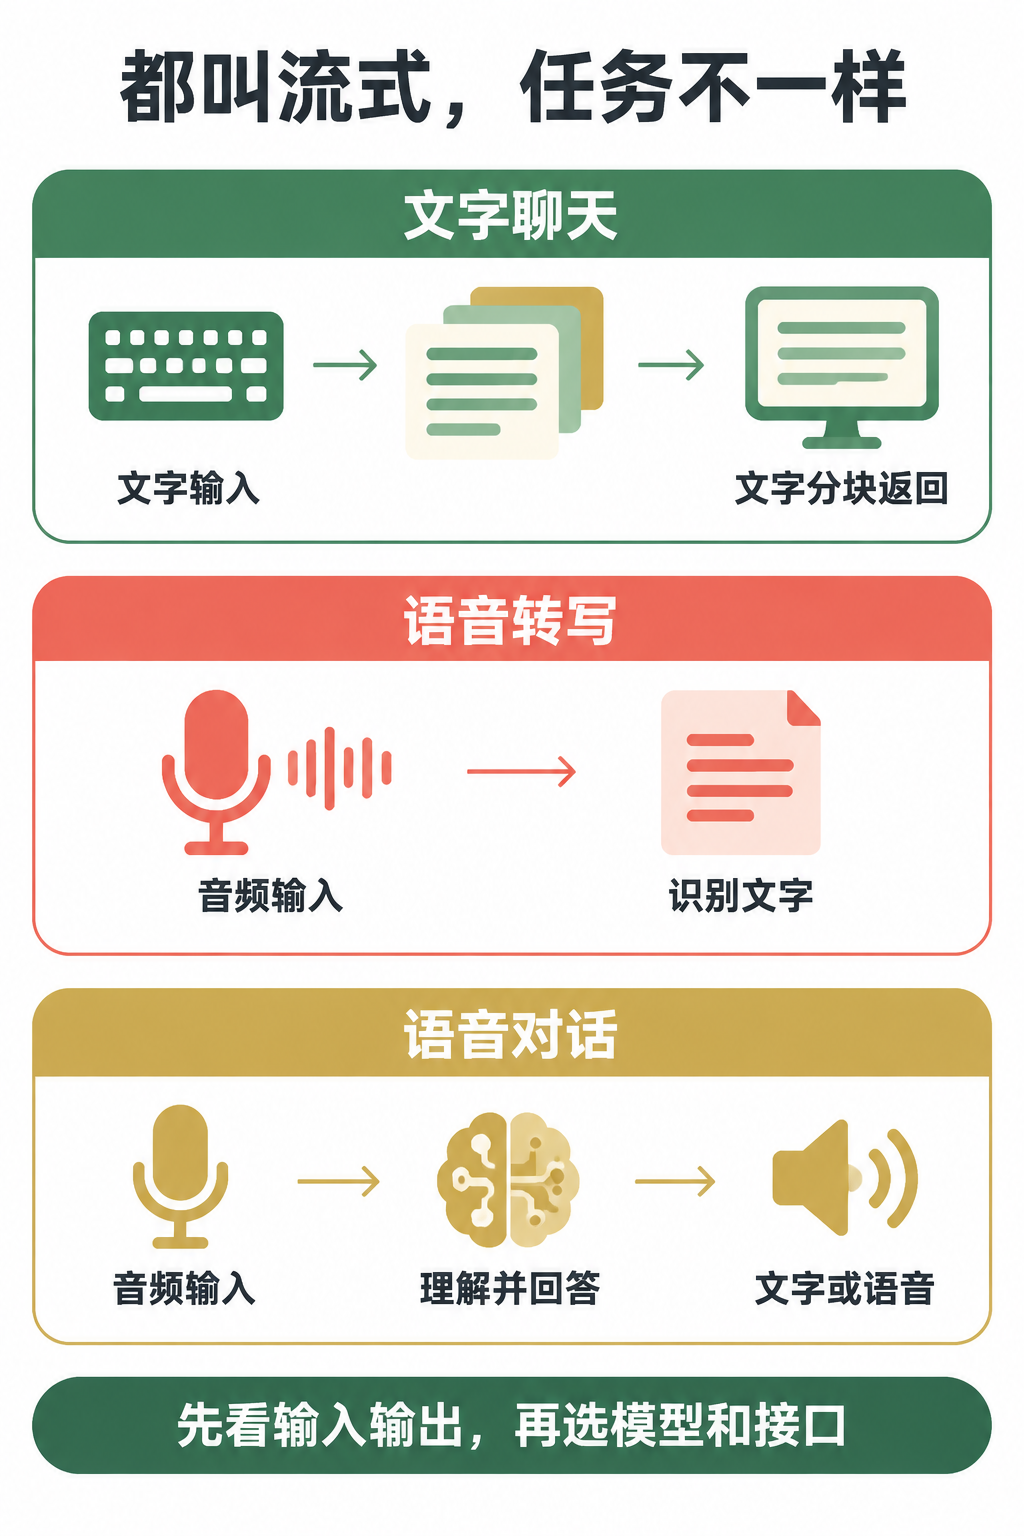
图:AI 生成的知识图。三行表示三类任务,不代表它们的延迟或性能相同。
第一类:文字聊天,边生成边显示。
你发一段文字,服务把回答分成小块往回送,客户端逐步显示。这里的“流式”说的是返回方式;仅凭这项能力,判断不了模型会不会听音频、能不能说话。
好比饭菜一道道上桌,这能说明上菜方式,不能说明厨师会唱二人转。别给人家临时加节目。
第二类:语音转写,把说的话记下来。
会议字幕、口述笔记,核心是音频进、文字出。实时转写可以一边接收音频,一边给出识别文字,但它不因此具备替你回答问题的完整对话能力。
在 llama.cpp v0.8.0 的文档里,实时转写使用 WebSocket /v1/realtime。对于文档所述可同时承担对话的 live ASR 模型,要明确使用 intent=transcription 区分转写任务。别把“同一个地址”理解成“同一个行为”。
第三类:语音对话,听完还得接得上话。
这里除了音频输入,还要管理对话上下文、生成回答,并在需要时输出语音。客户端得知道什么时候提交这一轮、什么时候开始回答、怎么播放返回的音频。
如果你现在只有文字聊天,可以搭“语音转文字 → 文字模型回答 → 文字转语音”的组合方案;也可以选有相应能力的音频模型和实时会话接口。组合方案同样能做语音助手,是否采用原生音频模型,要看功能、效果和成本,不必只追一个‘实时’名头。
llama.cpp 这次支持到哪,不能脑补到哪?
它的版本文档给了具体的会话约定:对话音频分块送入,提交用户这一轮后,再请求生成回答;返回事件可带文字或音频。音频输入输出还有各自的格式、声道和采样率要求。
有两处值得先核对:
- 音频格式跟模型走。 文档要求 PCM16、单声道;输入采样率从
session.created的audio.input.format.rate读取,输出则看audio.output.format.rate。不要凭耳熟就把所有音频都当成固定采样率。 - “停止生成”与“停止播放”分开验收。 文档列出
response.cancel取消生成事件;已经到达客户端、排进播放队列的声音,仍需客户端处理。只取消服务端生成,不能据此保证喇叭立即安静。
所以,“有实时接口”还不能当作“随时插话都灵、双方同时说也不卡”的验收结果。自动判断停顿、打断后的上下文、播放队列是否清理,都要在你选定的模型和客户端上分别验证。
另外,发布说明里的 mtmd_audio_stream 仍标为实验性 API。开源项目提供能力,与你的具体模型、构建和客户端能稳定配合,是两件需要分别确认的事。本篇没有测延迟,也没有测并发。
动手前,照这张单子过一遍
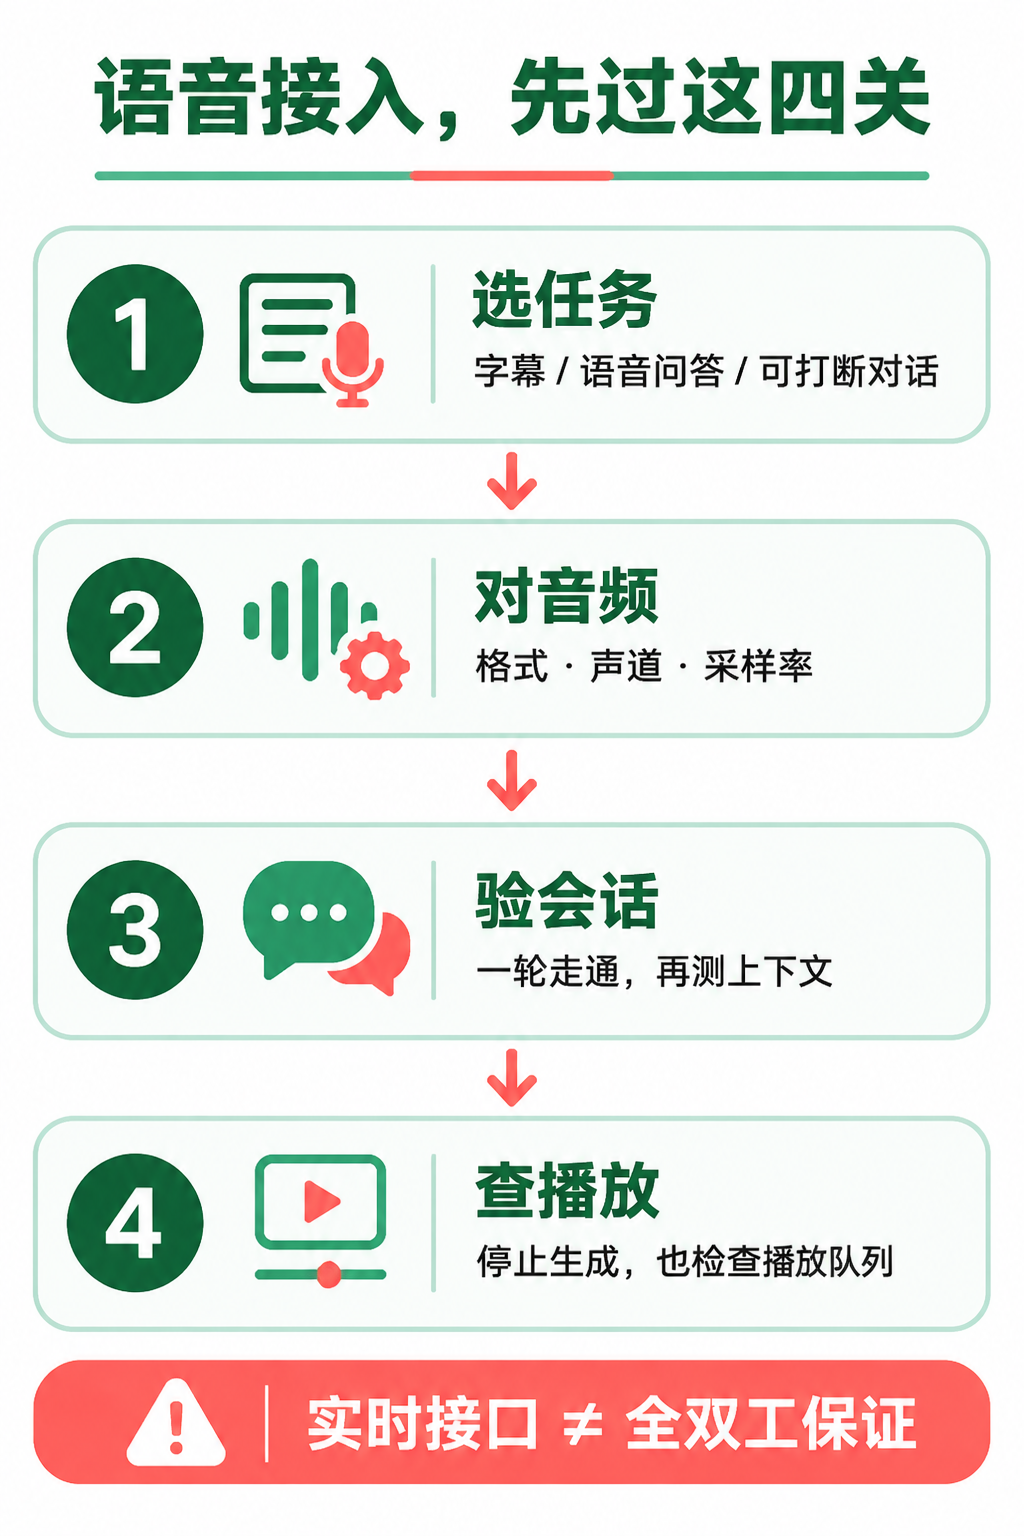
图:AI 生成的接入检查图。它是核对顺序,不是运行成功的截图。
只要会议字幕? 先验证一段无隐私的短音频能否持续返回识别文字;不必先把聊天和语音合成全装上。
要 AI 开口回答? 先用一条短问题,检查“音频送达 → 回答生成 → 声音播放”能否完整走通,再测第二轮是否接得上上下文。
要像打电话一样交流? 在上一项通过后,再测停顿、打断和恢复:AI 说到一半你插话,旧声音会不会继续播?下一轮会不会把已取消的回答当成完整说过?这些比界面上多一个麦克风图标更值得验。
出现问题时,先保存脱敏后的会话错误、事件顺序和音频格式信息。不要为了排错,把真实客户录音或完整 API Key 发进群里。
星桥 API 由我们运营。若你通过星桥给现有工具接入模型,可从「阅读原文」查看接入文档,再核对目标模型、端点及当前权限。本文没有声称星桥已提供 llama.cpp 的实时语音能力;文字接口可用,也不能代替音频链路验证。
选型先把任务说清:要字幕、要开口回答,还是要能打断的对话。目标定准了,再挑模型和接口,省得给文字聊天焊个麦克风,就催它上台唠嗑。
资料:llama.cpp v0.8.0 Release;同版本 tools/server/README.md 的 Realtime transcription、Realtime conversation 与 POST /tts 章节。发布日期:2026-10-28;本文核对:2026-10-29。本文为文档解读,非星桥实测。配图由星桥 API 辅助生成,均为概念说明图。